怎么看这两张图
节点 = 算子,箭头 = 张量流向。ONNX 图是模型导出时的原始算子(权重隐藏);
MLIR 图是 tpu-mlir 把 ONNX 导入为 top 方言后的样子(权重画成 top.Weight 节点)。
两边节点名(loc)一致,可以逐节点对照。
为什么 MLIR 节点数会变
导入时会做常量折叠与算子融合:ReLU 融进 Conv(do_relu)、BN 融成 Scale、
SiLU 从 Sigmoid+Mul 融合成单个算子、动态 Shape 运算被静态化。所以 MLIR 图通常更「短」,也更接近硬件视角。
三个结构统计
深度 = 最长路径长度(串行程度);分支点 = 扇出 ≥2 的节点; 汇合点 = 扇入 ≥2 的节点(Add/Concat/Sum)。链式网络三者是「深、0、0」, 残差/多分支网络则会出现大量分叉-汇合回路。
卷积 Conv池化 Pool激活 Relu/Clip归一化 Norm矩阵乘 MatMul逐元素 Add/Mul拼接 Concat/Split形状变换 Reshape/Transpose归约/Softmax量化/Cast其它
横向对比:结构签名一眼区分
| 模型 | 范式 | ONNX 节点 | 深度 | 分支点 | 汇合点 | 分组卷积 | 结构签名 |
|---|---|---|---|---|---|---|---|
| VGG-19 | 纯卷积链 | 47 | 47 | 0 | 0 | 0 | 无分叉的长链 |
| ResNet-50 | 残差 | 174 | 170 | 16 | 16 | 0 | Add 回路 ×16 |
| GoogLeNet | Inception | 143 | 62 | 9 | 9 | 0 | Concat 汇合 ×9 |
| SqueezeNet | Fire | 66 | 50 | 8 | 8 | 0 | Concat 汇合 ×8 |
| MobileNetV2 | Depthwise+残差 | 105 | 103 | 11 | 12 | 17 | 1×1→DW3×3→1×1 |
| ShuffleNet | 分组卷积 | 203 | 200 | 16 | 16 | 48 | Reshape/Transpose 重排 |
| EfficientNet-Lite4 | MBConv | 188 | 188 | 23 | 23 | 30 | DW 卷积密集堆叠 |
| YOLOv5s | 检测 | 392 | 190 | 123 | 135 | 0 | Concat ×41 + 3 尺度输出 |
| BERT-SQuAD | Transformer | 1167 | 681 | 145 | 301 | 0 | MatMul/Softmax + 残差 |
| Qwen3.5 block | LLM 解码层 | 73* | — | 11* | 24* | 0 | RMSNorm/RoPE/SiLU |
* Qwen 行为 MLIR 图统计(该层无 ONNX);“深度”依赖 ONNX 拓扑,故留空。
01
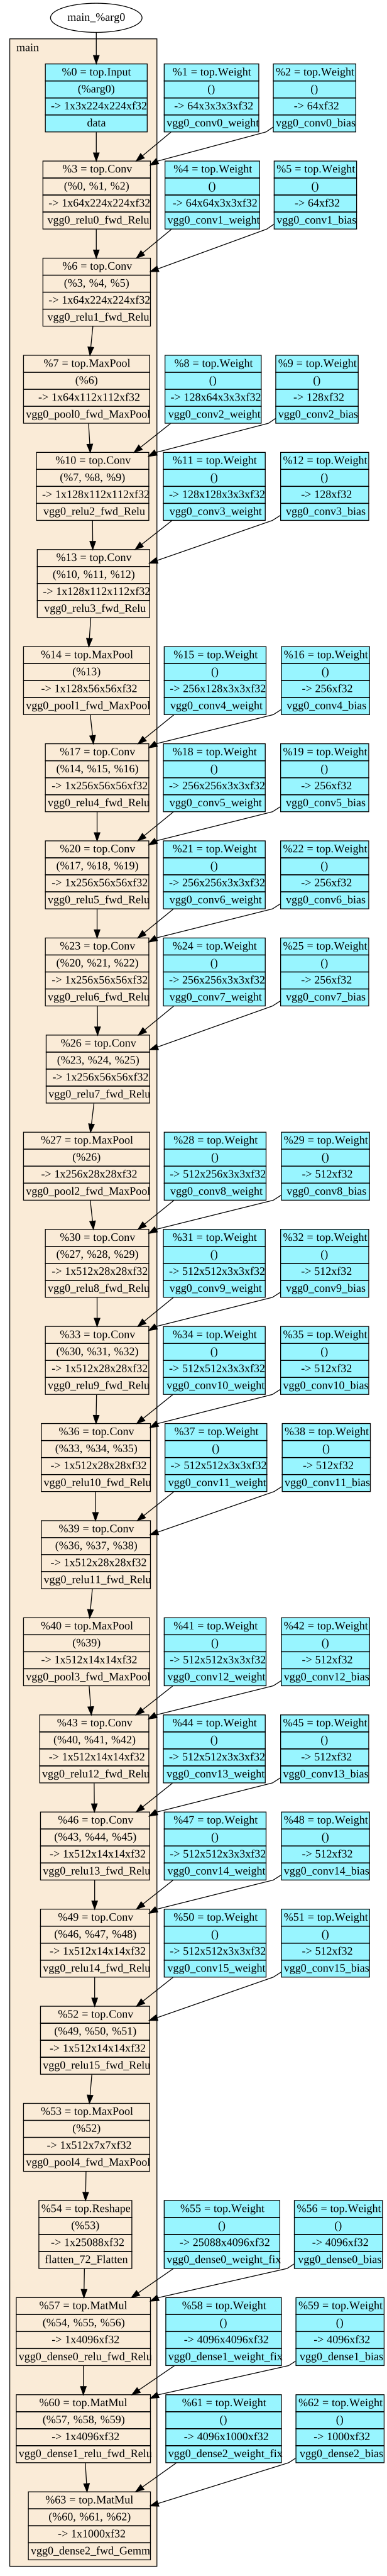
VGG-19 纯卷积 · 链式堆叠
- 全图只有 一条链:0 个分支点、0 个汇合点,深度 = 节点数(47)。
- 16 层卷积全部是 3×3,5 次 MaxPool 把特征图从 224 降到 7。
- ONNX 里 Conv 与 Relu 是两个节点;MLIR 里卷积把激活融合进算子属性(
do_relu=true),所以 MLIR 图里看不到 Relu。 - MLIR 图把每个权重画成独立的
top.Weight节点(38 个),ONNX 图默认隐藏权重。
ONNX 节点47
MLIR 节点63
深度47
分支点0
汇合点0
分组卷积0
权重节点38
分辨率阶段(按特征图尺寸切分)
224×224
4 ops
Conv×2 Relu×2
112×112
5 ops
Conv×2 Relu×2 MaxPool×1
56×56
9 ops
Conv×4 Relu×4 MaxPool×1
28×28
9 ops
Conv×4 Relu×4 MaxPool×1
14×14
9 ops
Conv×4 Relu×4 MaxPool×1
7×7
1 ops
MaxPool×1
ONNX 算子直方图(前 8)

02
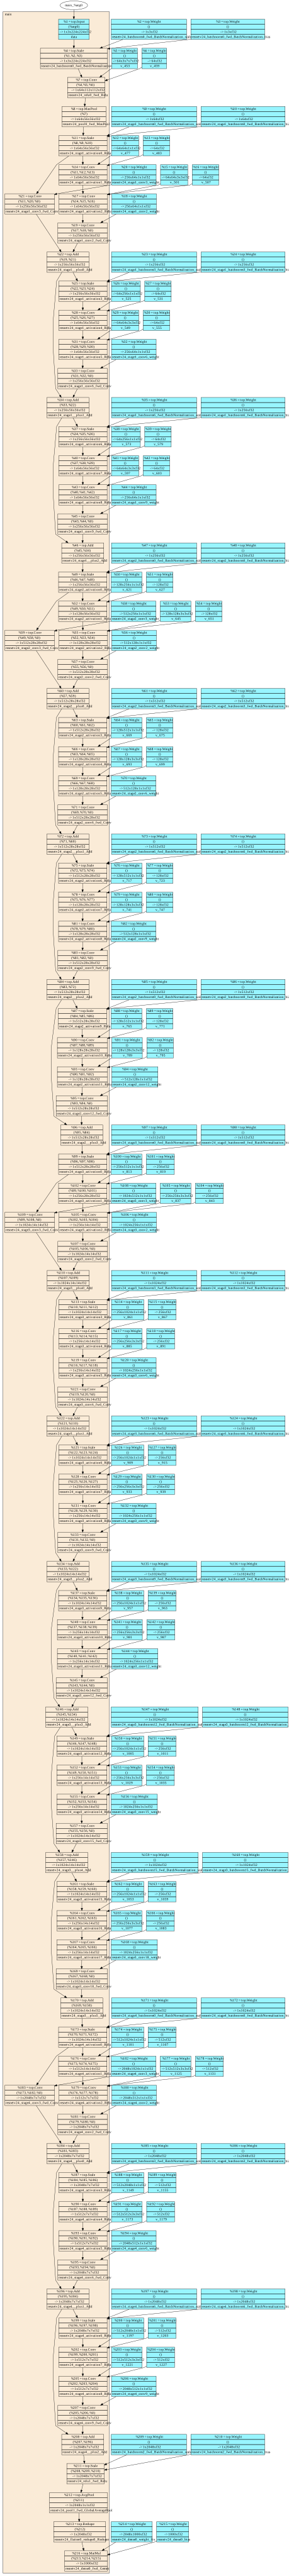
ResNet-50 v2 残差连接 · 跨层短路
- 16 个 Add 汇合点 就是残差连接:主路径卷积输出与 shortcut 相加。
- 图中能看到清晰的「分叉 → 一串卷积 → 回到 Add」的环状回路,这是残差网络的结构签名。
- 阶段划分:56×56 有 3 个 block,28×28 有 4 个,14×14 有 6 个,7×7 有 3 个(Bottleneck 1×1-3×3-1×1)。
- MLIR 中 BatchNorm 被折叠成
Scale(18 个),Conv 仍是 53 个,Add 16 个原样保留。
ONNX 节点174
MLIR 节点215
深度170
分支点16
汇合点16
分组卷积0
权重节点124
分辨率阶段(按特征图尺寸切分)
224×224
1 ops
BatchNormalization×1
112×112
3 ops
Conv×1 BatchNormalization×1 Relu×1
56×56
37 ops
BatchNormalization×11 Relu×11 Conv×11 Add×3
28×28
41 ops
Conv×13 BatchNormalization×12 Relu×12 Add×4
14×14
61 ops
Conv×19 BatchNormalization×18 Relu×18 Add×6
7×7
28 ops
Conv×9 BatchNormalization×8 Relu×8 Add×3
1×1
1 ops
GlobalAveragePool×1
ONNX 算子直方图(前 8)

03
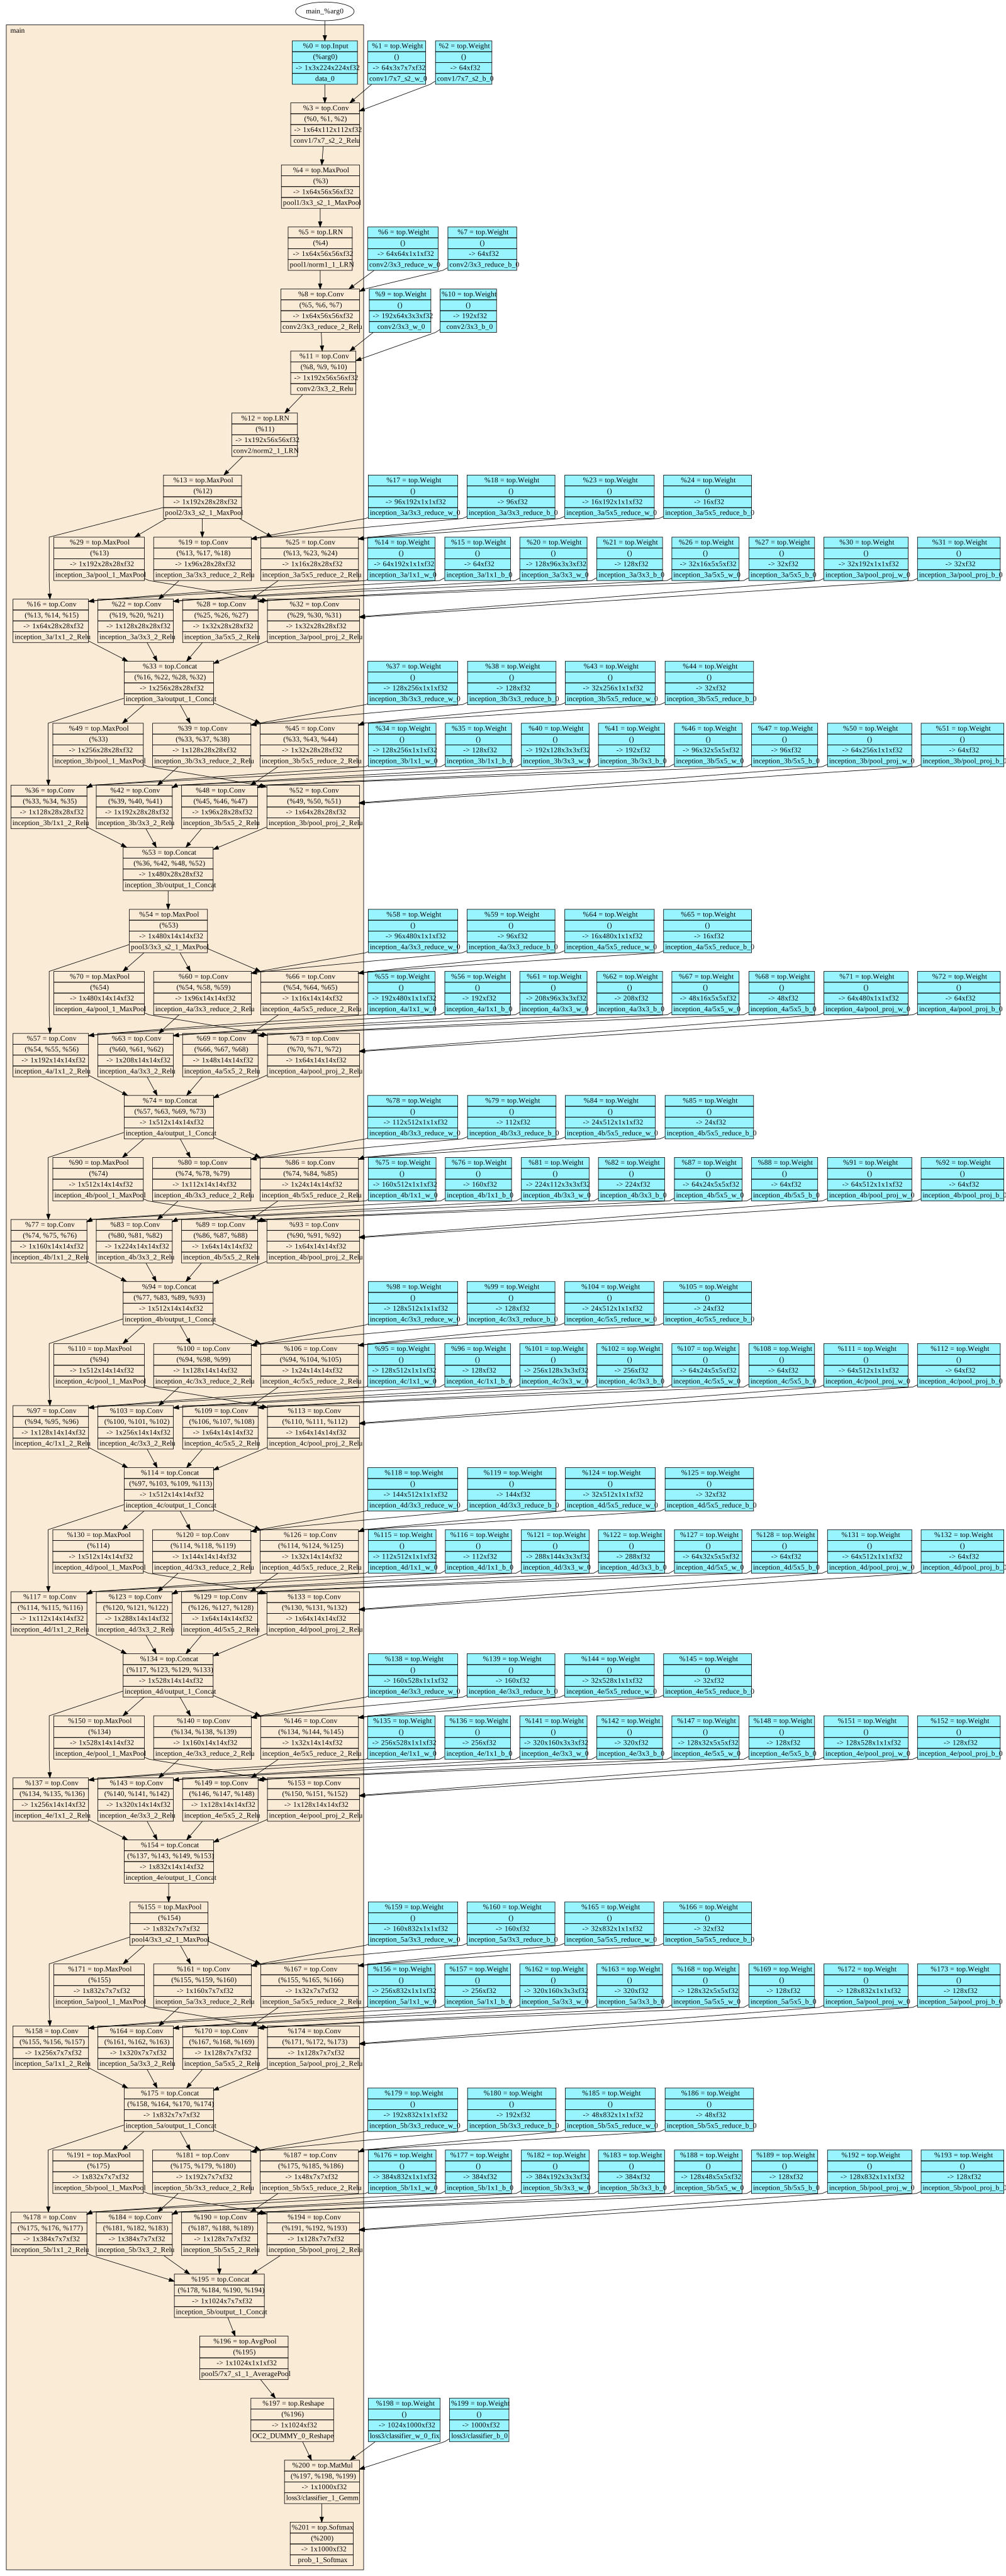
GoogLeNet (Inception v1) Inception · 多分支并行
- 9 个 Concat 汇合点:每个 Inception 模块把 4 条并行支路(1×1、1×1→3×3、1×1→5×5、3×3Pool→1×1)拼起来。
- 深度只有 62,远小于节点数 143 —— 说明大量算力花在并行分支而不是串行堆叠上。
- 图呈「梳子」状:同一张量扇出 4 路,末端用 Concat 合流;14×14 阶段最宽(71 个算子)。
- 早期用 LRN、后期用全局平均池化,是 2014-2015 年 CNN 的典型写法。
ONNX 节点143
MLIR 节点202
深度62
分支点9
汇合点9
分组卷积0
权重节点116
分辨率阶段(按特征图尺寸切分)
112×112
2 ops
Conv×1 Relu×1
56×56
7 ops
LRN×2 Conv×2 Relu×2 MaxPool×1
28×28
29 ops
Conv×12 Relu×12 MaxPool×3 Concat×2
14×14
71 ops
Conv×30 Relu×30 MaxPool×6 Concat×5
7×7
29 ops
Conv×12 Relu×12 MaxPool×3 Concat×2
1×1
2 ops
AveragePool×1 Dropout×1
ONNX 算子直方图(前 8)

04
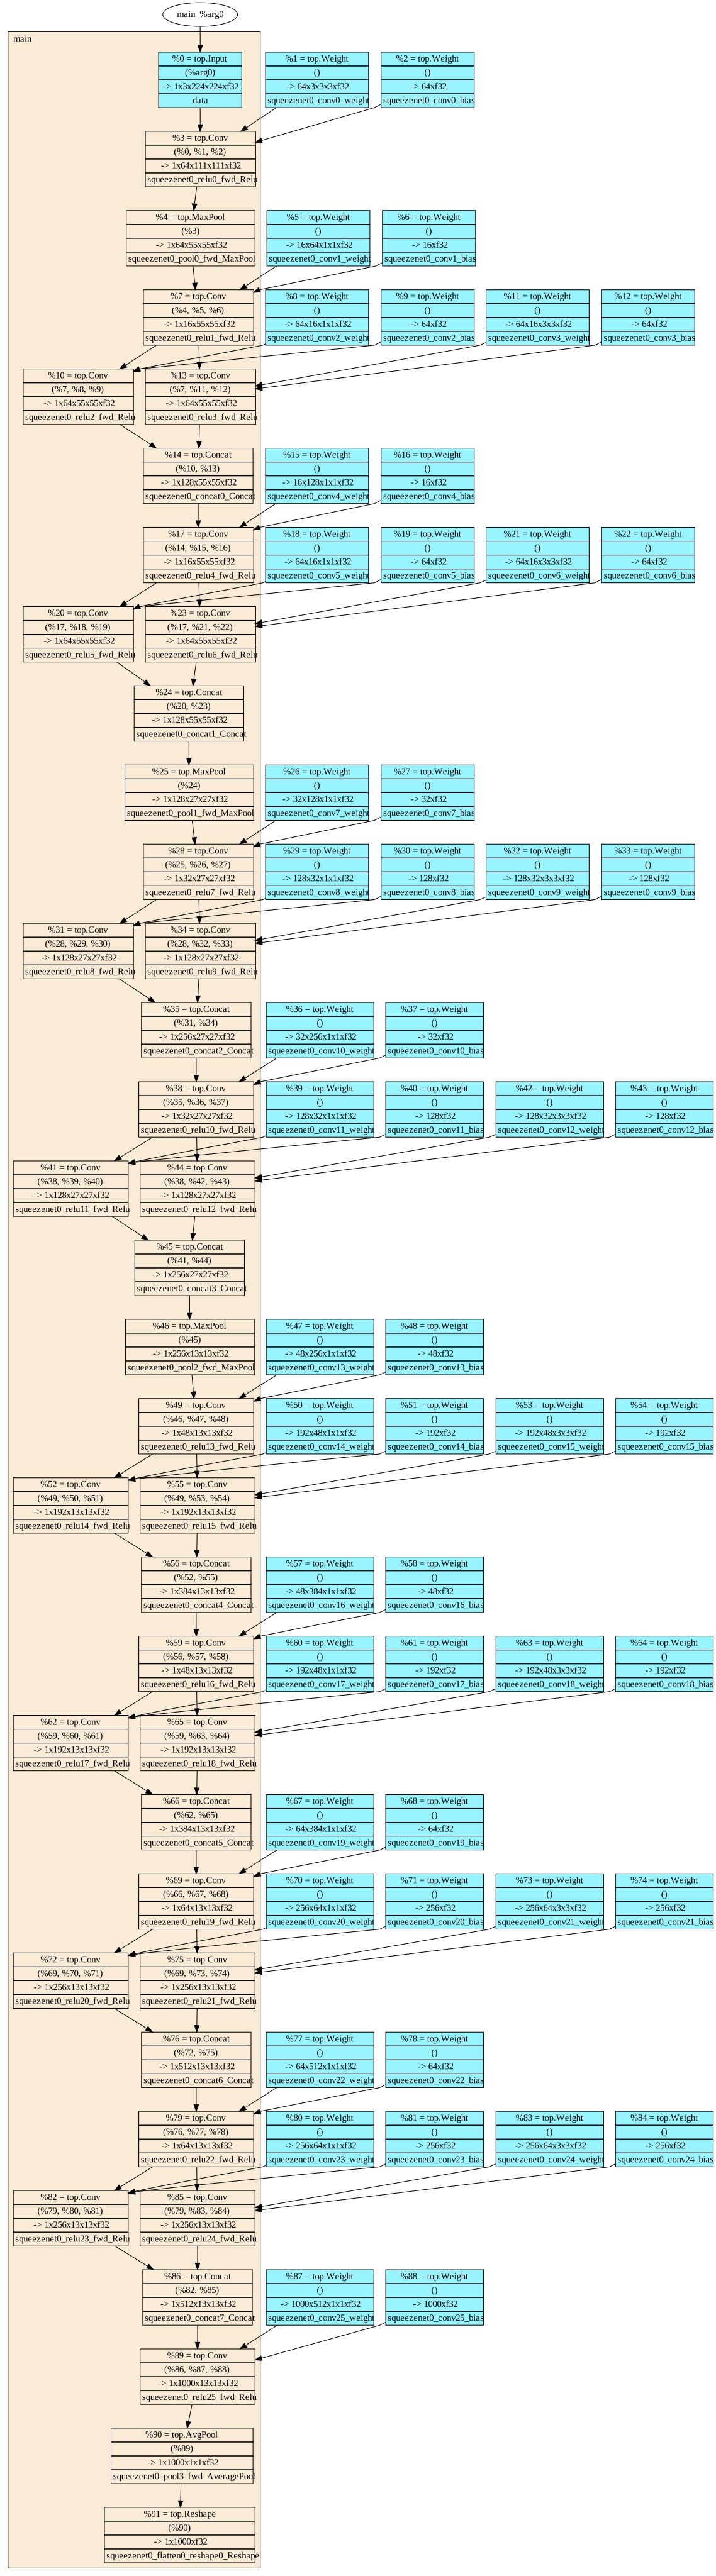
SqueezeNet 1.1 Fire 模块 · 先压后扩
- 核心单元是 Fire 模块:1×1 卷积把通道压到很少(squeeze),再并行 1×1/3×3 卷积扩回(expand),最后 Concat。
- 8 个 Concat 就是 8 个 Fire 模块的汇合点;全图没有 Add,即没有残差。
- 结构极窄:只有 66 个 ONNX 节点、26 个卷积,是「用小卷积核换参数量」的代表。
- MLIR 视图同样把 Conv 后的 ReLU 融合掉,只剩 Conv / Concat / Pool。
ONNX 节点66
MLIR 节点91
深度50
分支点8
汇合点8
分组卷积0
权重节点52
分辨率阶段(按特征图尺寸切分)
111×111
2 ops
Conv×1 Relu×1
55×55
15 ops
Conv×6 Relu×6 Concat×2 MaxPool×1
27×27
15 ops
Conv×6 Relu×6 Concat×2 MaxPool×1
13×13
32 ops
Conv×13 Relu×13 Concat×4 MaxPool×1
1×1
1 ops
AveragePool×1
ONNX 算子直方图(前 8)

05
MobileNetV2 深度可分离卷积 · 倒残差
- 17 个 depthwise 卷积(
group = 输入通道数),每个倒残差块是「1×1 扩张 → 3×3 depthwise → 1×1 投影」。 - 10 个 Add 是倒残差块的短路;通道数先扩张 6 倍再压缩,所以图在「宽-窄」之间反复。
- 激活是 ReLU6,在 ONNX 里表现为 Clip(35 个);MLIR 中同样保留为 Clip。
- MLIR 的图更紧凑(约 69 个节点):权重被当作卷积系数内联,不再画成独立节点。
ONNX 节点105
MLIR 节点69
深度103
分支点11
汇合点12
分组卷积17
权重节点6
分辨率阶段(按特征图尺寸切分)
112×112
7 ops
Conv×4 Clip×3
56×56
11 ops
Conv×6 Clip×4 Add×1
28×28
17 ops
Conv×9 Clip×6 Add×2
14×14
40 ops
Conv×21 Clip×14 Add×5
7×7
22 ops
Conv×12 Clip×8 Add×2
1×1
1 ops
GlobalAveragePool×1
ONNX 算子直方图(前 8)


06
ShuffleNet 分组卷积 · 通道重排
- 48 个分组卷积(group > 1)是主体;每次分组卷积后用 channel shuffle 打乱通道。
- ONNX 里 shuffle 没有专用算子,被拆成 Reshape → Transpose → Reshape(33 个 Reshape、16 个 Transpose),这是它最好认的图形特征。
- 残差用 Sum(13 个)而不是 Add;分支点多达 16 个,图比较「碎」。
- MLIR 中 Transpose 变成 Permute,Sum 变成 Add,结构一一对应。
ONNX 节点203
MLIR 节点222
深度200
分支点16
汇合点16
分组卷积48
权重节点100
分辨率阶段(按特征图尺寸切分)
112×112
3 ops
Conv×1 BatchNormalization×1 Relu×1
56×56
4 ops
MaxPool×1 Conv×1 BatchNormalization×1 Relu×1
56×56
1 ops
Reshape×1
28×28
10 ops
Conv×3 BatchNormalization×3 Relu×2 AveragePool×1
28×28
10 ops
Conv×3 BatchNormalization×3 Relu×2 Reshape×1
28×28
10 ops
Conv×3 BatchNormalization×3 Relu×2 Reshape×1
28×28
10 ops
Conv×3 BatchNormalization×3 Relu×2 Reshape×1
28×28
1 ops
Reshape×1
14×14
10 ops
Conv×3 BatchNormalization×3 Relu×2 AveragePool×1
14×14
10 ops
Conv×3 BatchNormalization×3 Relu×2 Reshape×1
14×14
10 ops
Conv×3 BatchNormalization×3 Relu×2 Reshape×1
14×14
10 ops
Conv×3 BatchNormalization×3 Relu×2 Reshape×1
14×14
10 ops
Conv×3 BatchNormalization×3 Relu×2 Reshape×1
14×14
10 ops
Conv×3 BatchNormalization×3 Relu×2 Reshape×1
ONNX 算子直方图(前 8)


07
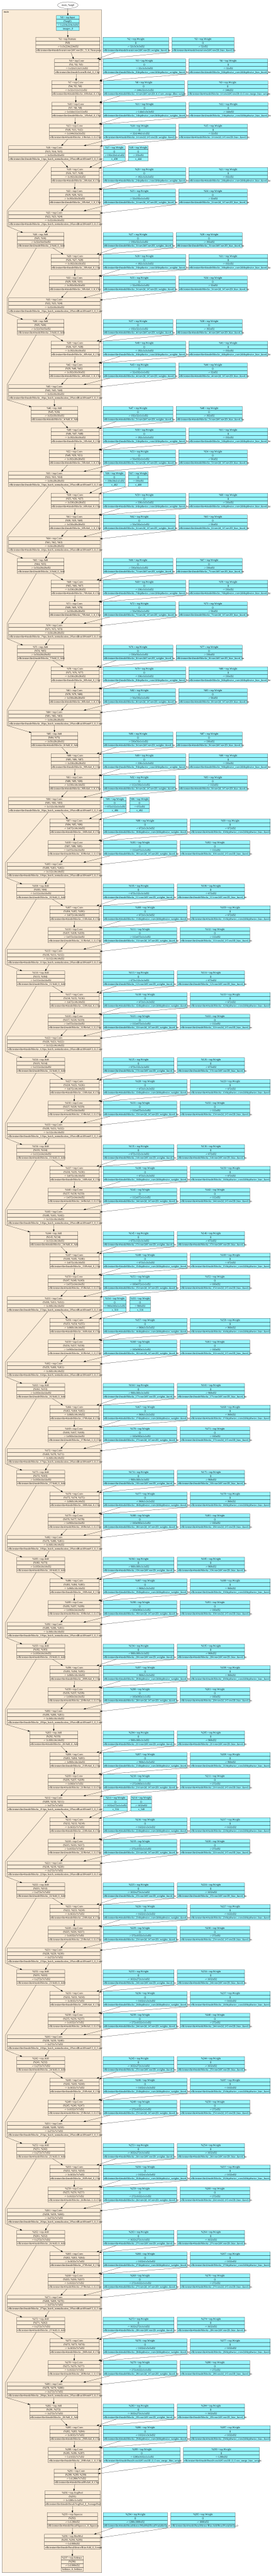
EfficientNet-Lite4 MBConv · 复合缩放
- 30 个 depthwise 卷积 + 大量 1×1 卷积:MBConv 块的典型形态,卷积总数 91。
- 23 个 Add 是残差汇合;注意输入是 NHWC,所以模型首尾各有一个 Transpose 做布局转换。
- 激活统一为 ReLU6(Clip 61 个);网络又深又窄,深度 188 接近节点数。
- MLIR 中 BatchNorm 基本被折叠,权重节点多达 180 个,图看起来比 ONNX 更「重」。
ONNX 节点188
MLIR 节点298
深度188
分支点23
汇合点23
分组卷积30
权重节点180
分辨率阶段(按特征图尺寸切分)
224×224
1 ops
Transpose×1
112×112
8 ops
Conv×4 Clip×3 BatchNormalization×1
56×56
24 ops
Conv×12 Clip×8 Add×3 BatchNormalization×1
28×28
24 ops
Conv×12 Clip×8 Add×3 BatchNormalization×1
14×14
72 ops
Conv×36 Clip×24 Add×10 BatchNormalization×2
7×7
54 ops
Conv×27 Clip×18 Add×7 BatchNormalization×2
1×1
1 ops
AveragePool×1
ONNX 算子直方图(前 8)

08
YOLOv5s 单阶段目标检测
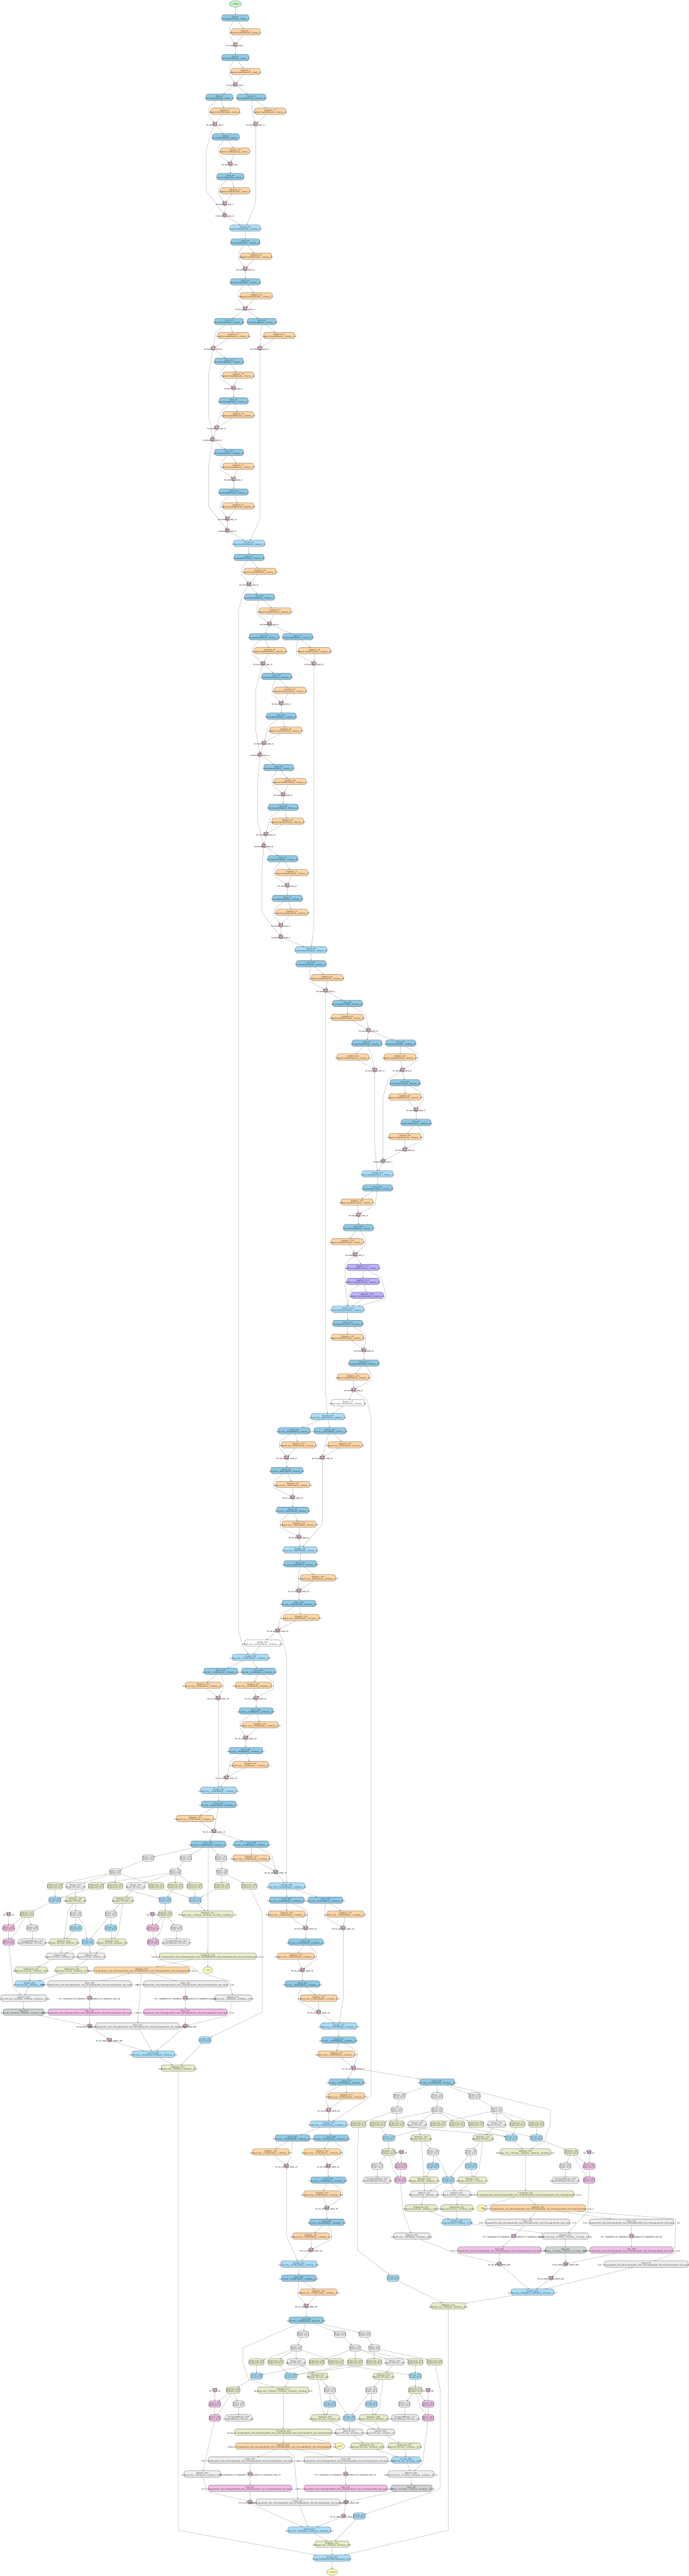
- CSP/C3 主干带来 123 个分支点、135 个汇合点(41 个 Concat),是十张图里分叉最多的 CNN。
- 三个输出对应 stride 8/16/32 的检测头,每个头输出
1×3×H×W×85(框 + 置信度 + 80 类)。 - ONNX 中 SiLU 被拆成 Sigmoid + Mul(各 60 个);到了 MLIR,它们被融合成 57 个
top.SiLU—— 这是「同模型、不同层」最直观的例子。 - 图末尾还有大量 Shape/Gather/Slice/Range 动态形状算子(后处理),它们在 MLIR 中被静态化,节点数从 392 降到 268。
ONNX 节点392
MLIR 节点268
深度190
分支点123
汇合点135
分组卷积0
权重节点120
分辨率阶段(按特征图尺寸切分)
?
197 ops
Conv×58 Sigmoid×57 Mul×57 Concat×13
?
1 ops
Conv×1
?
1 ops
Conv×1
ONNX 算子直方图(前 8)

09
BERT-SQuAD Transformer 编码器
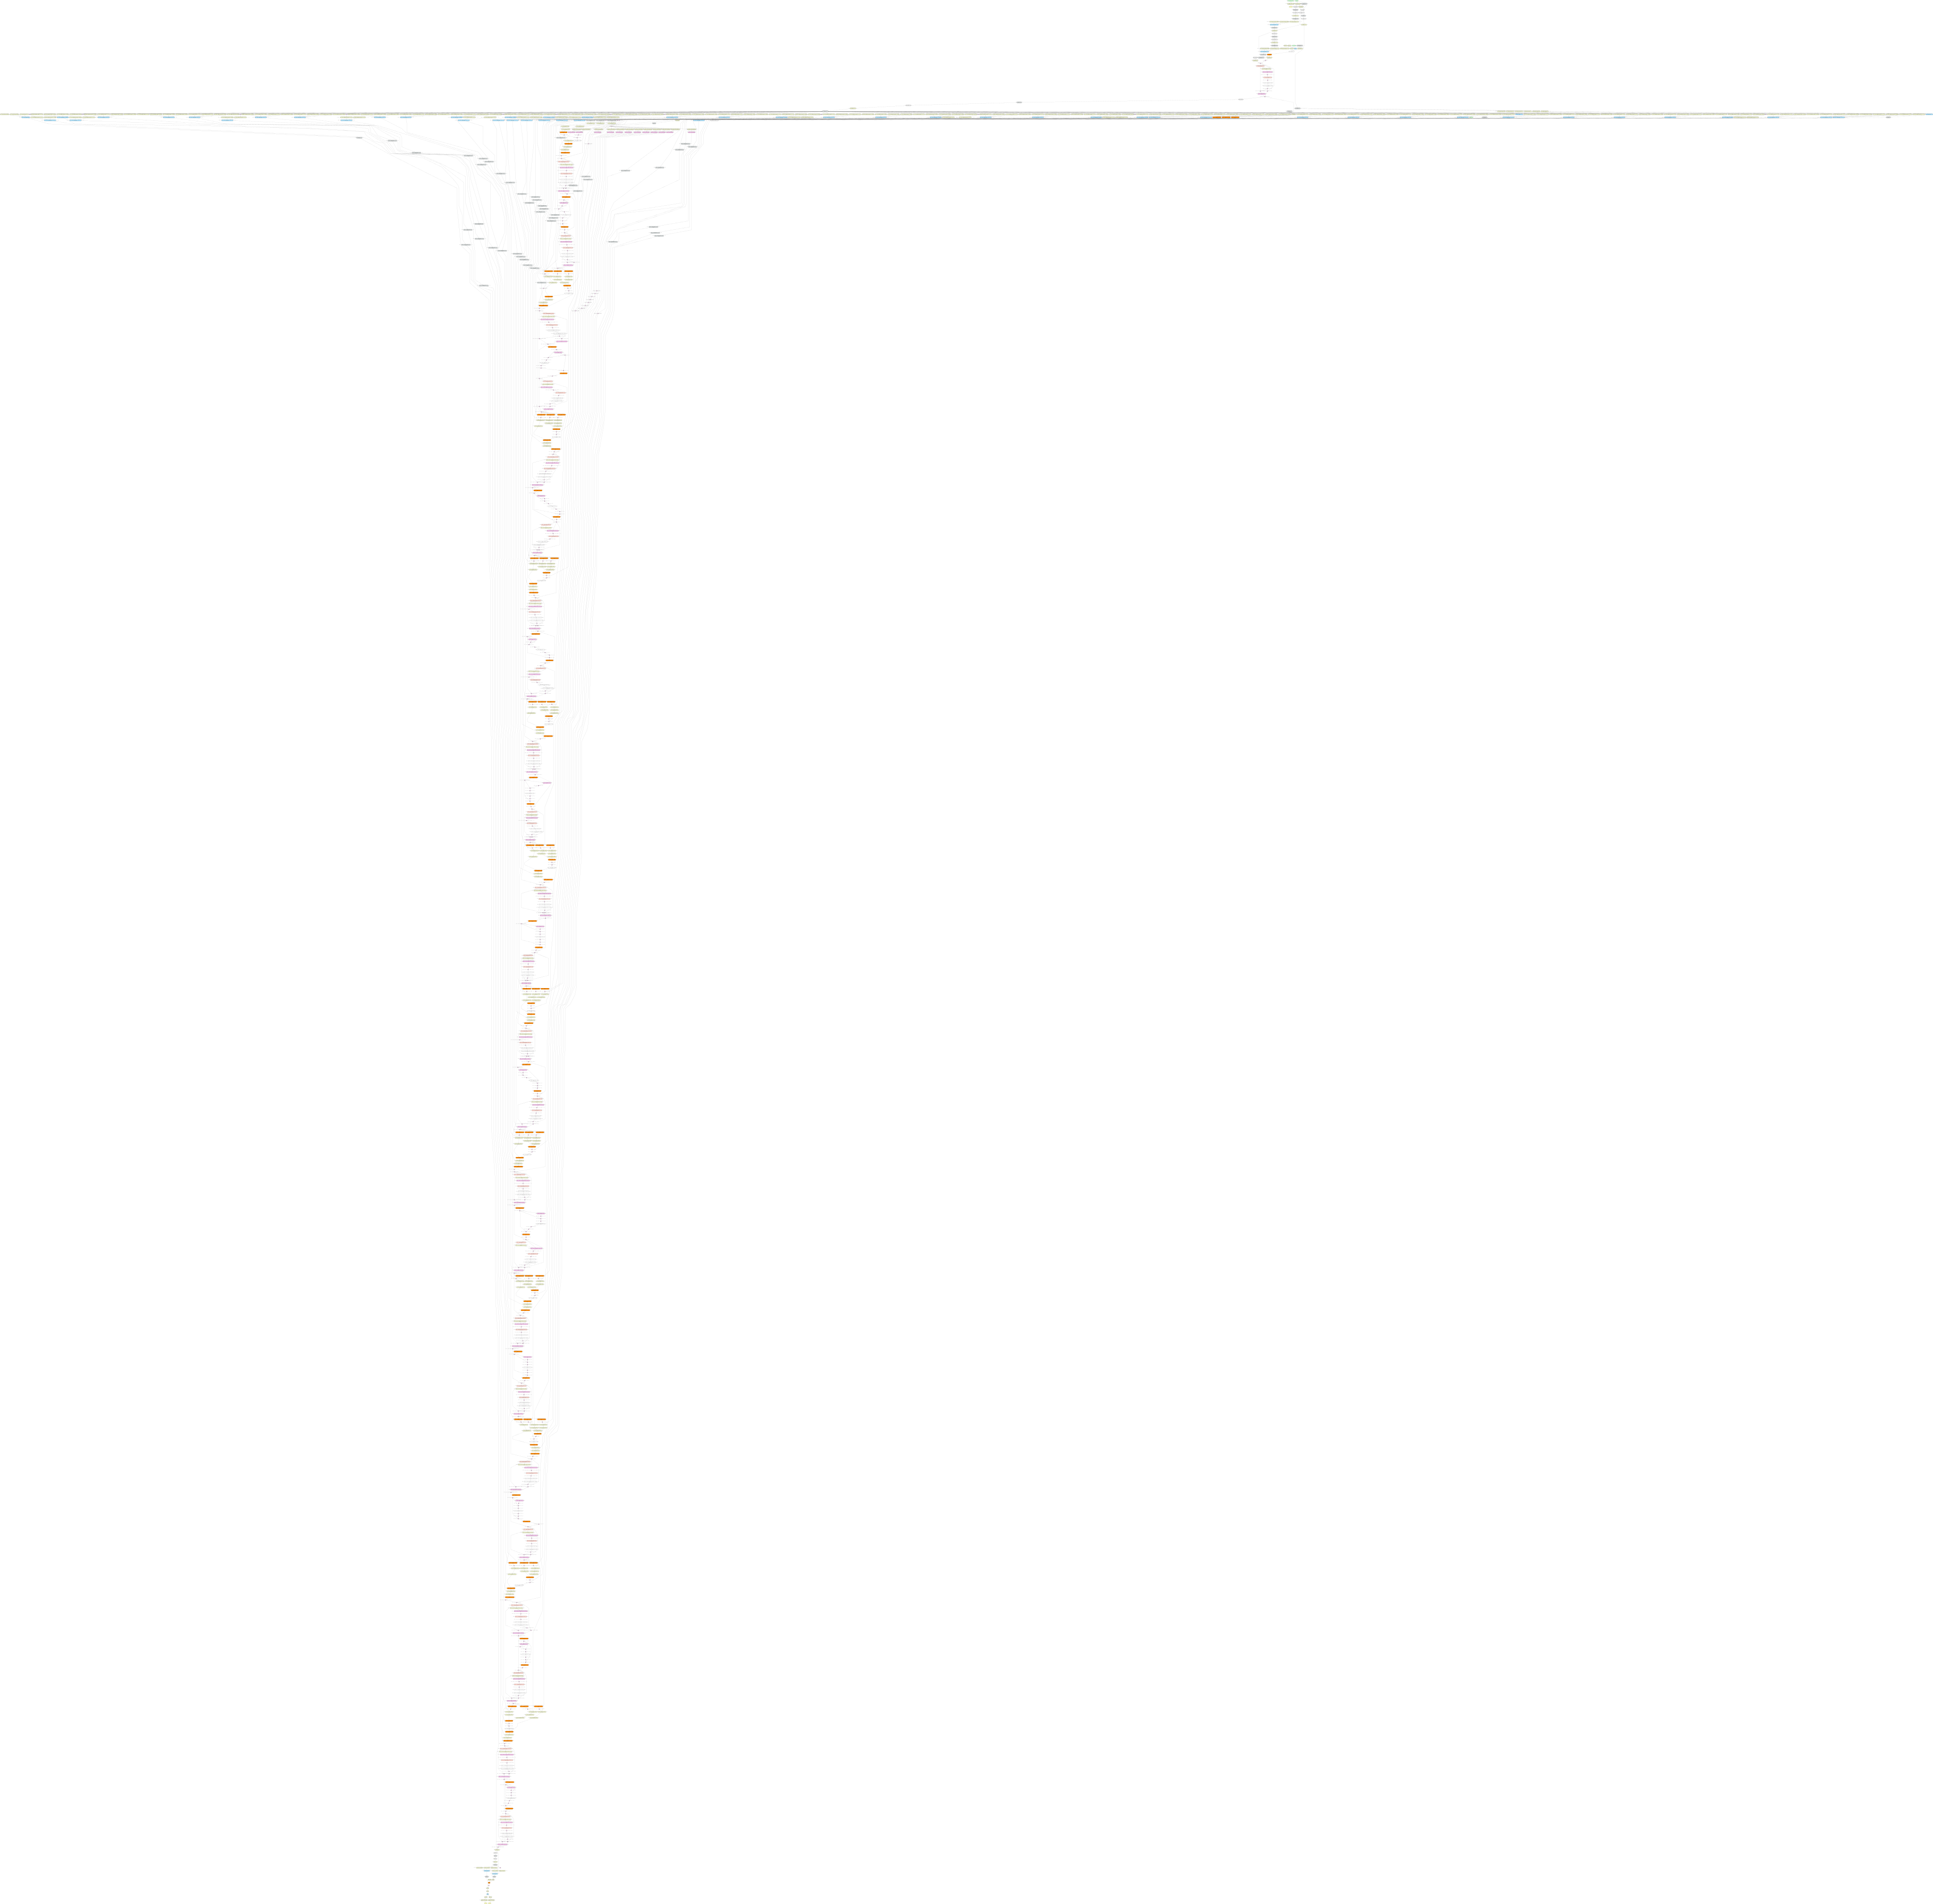
- 12 层 Transformer 编码器顺序堆叠:每层 1 个 Multi-Head Attention + 1 个 FFN,各自带残差 Add。
- ONNX 图有 185 个 Add、98 个 MatMul、12 个 Softmax;深度 681,是典型的「长链 + 密集短路」。
- LayerNorm 在 ONNX 里被拆成 ReduceMean/Sub/Sqrt/Mul/Add(50 个 ReduceMean),MLIR 中聚合成 50 个
top.Reduce。 - 共有 3 个输出(unique_ids 以及 start/end logits);注意它的输入是 int32,与视觉模型的 f32 输入不同。
ONNX 节点1167
MLIR 节点887
深度681
分支点145
汇合点301
分组卷积0
权重节点202
ONNX 算子直方图(前 8)

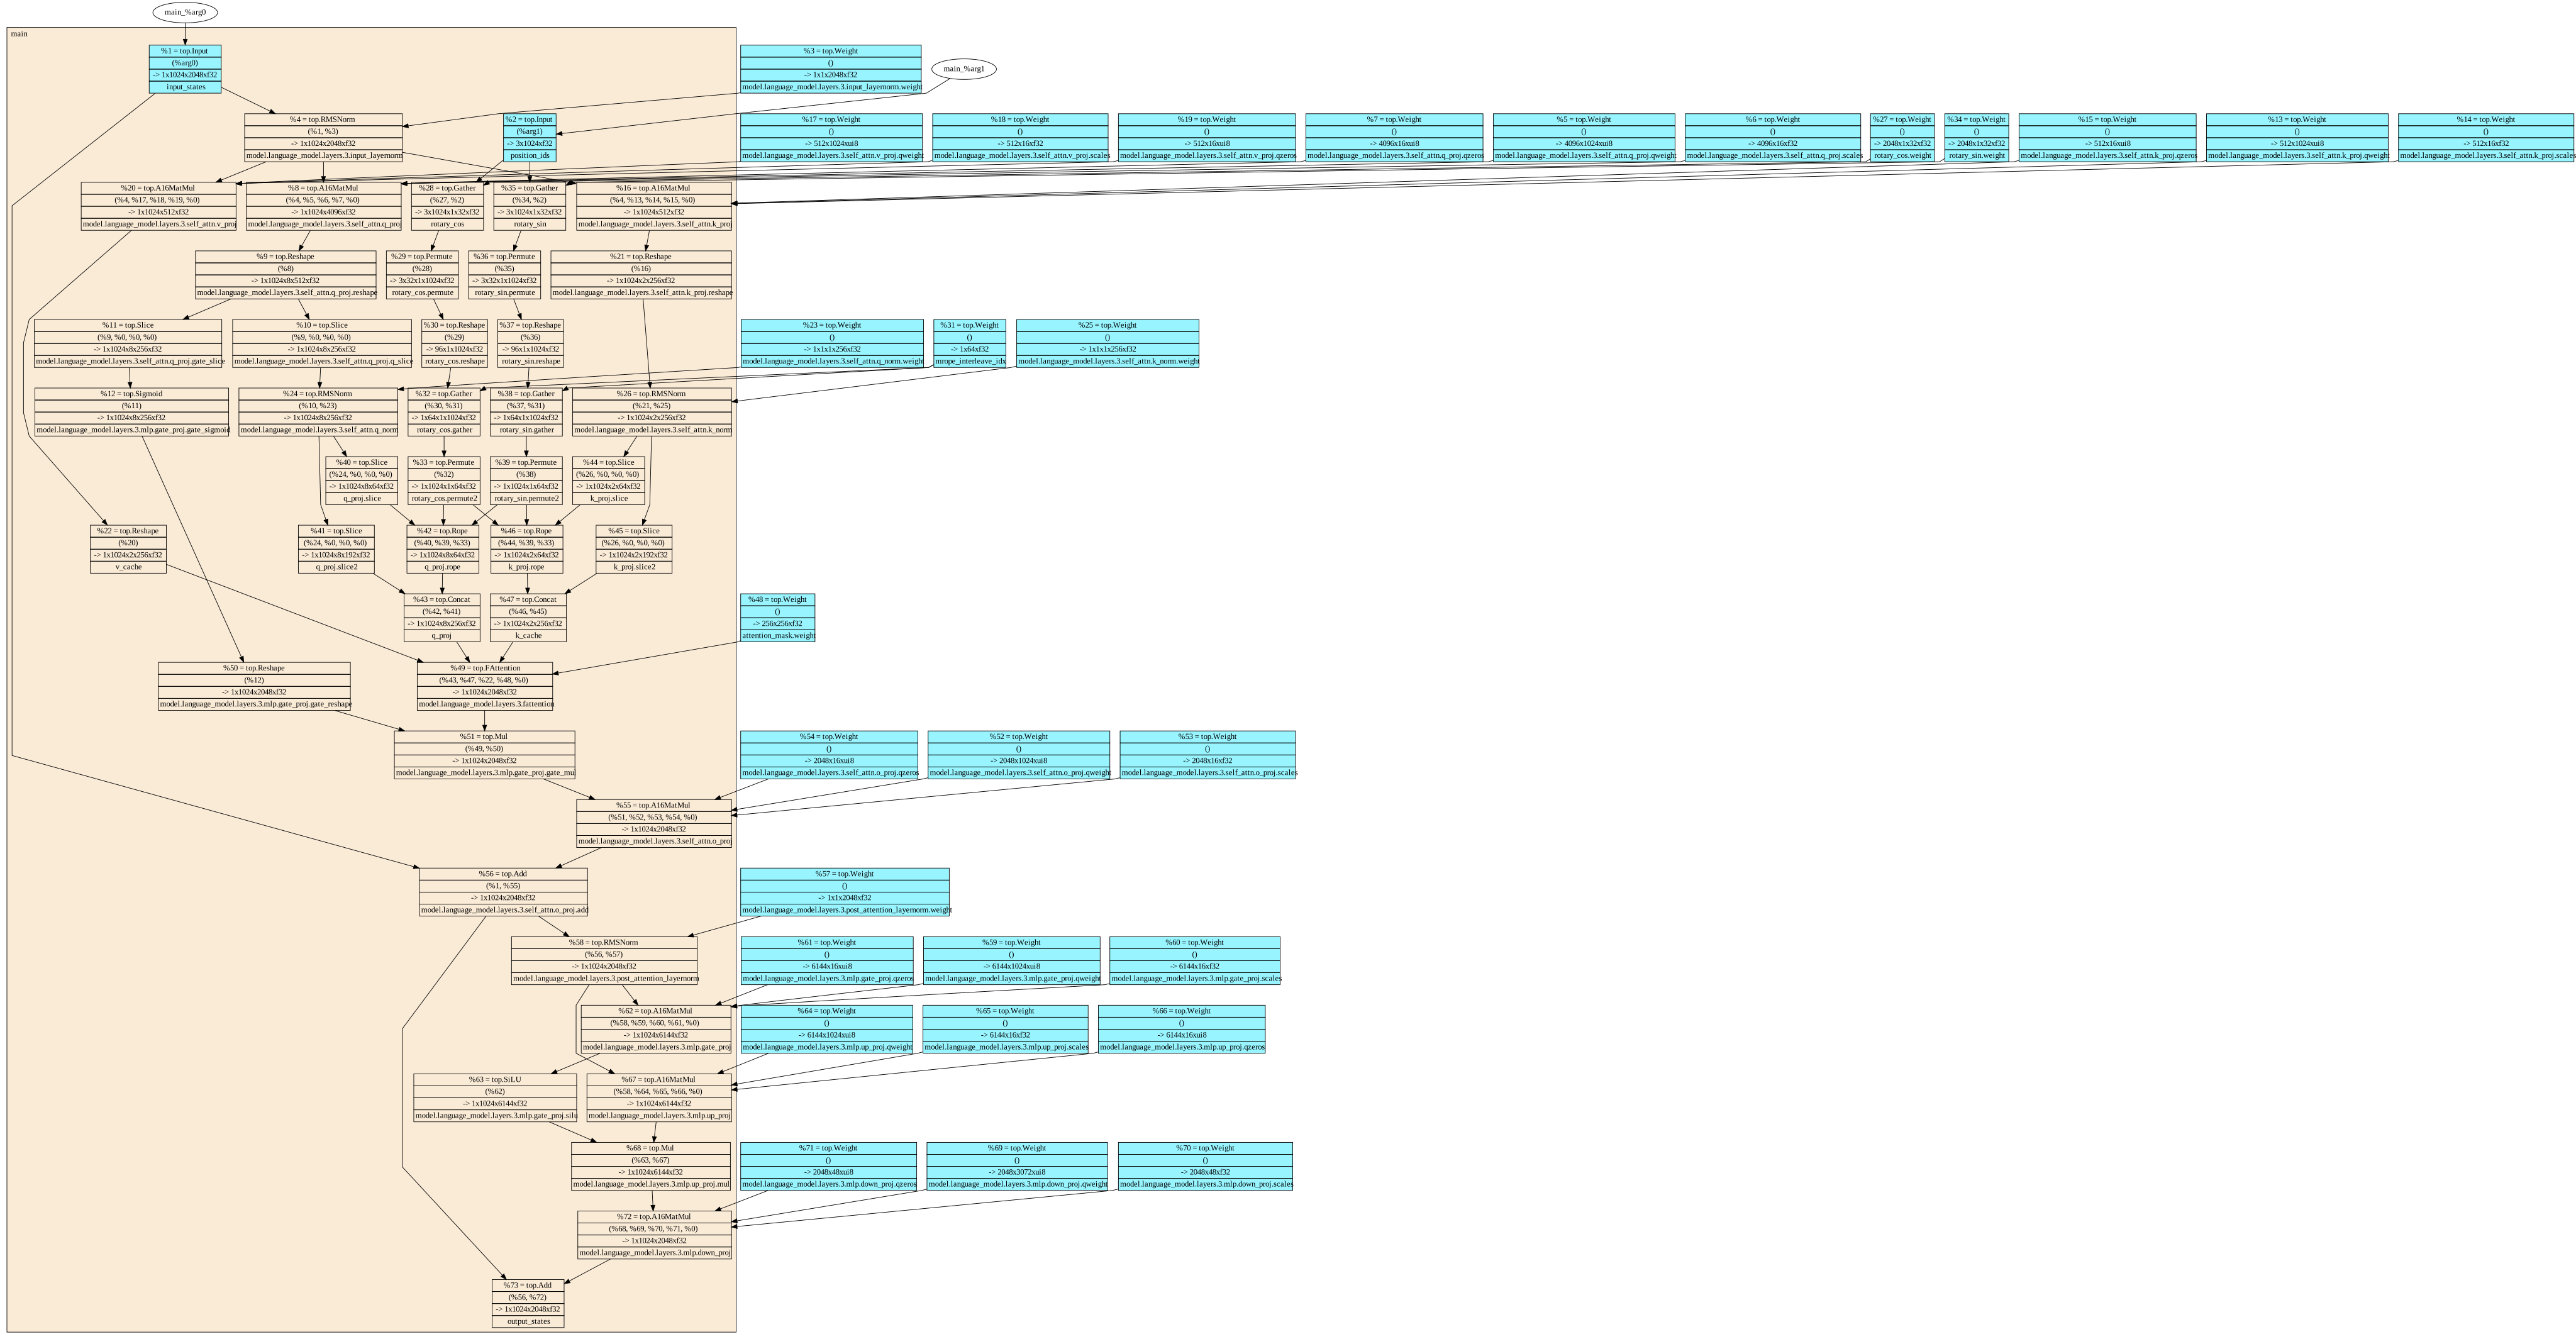
10
Qwen3.5 解码器层 (block_3) LLM · 因果注意力 + 门控 MLP
- 一个标准解码层:RMSNorm → Attention(RoPE, KV cache) → 残差 → RMSNorm → SiLU 门控 MLP → 残差。
- MLIR 里可以看到 4 个
top.RMSNorm、2 个top.Rope、7 个A16MatMul以及融合后的FAttention算子。 - KV cache 是额外的输入张量;QKV 的拆分由 Slice/Gather/Permute/Reshape 完成。
- 说明:Qwen3.5 还有线性注意力层(
ChunkGatedDeltaRule),当前 mlir2graph 版本未注册该算子,因此这里选标准注意力的 block_3 展示;该层无对应 ONNX。
MLIR 节点73
边86
分支点11
汇合点24
权重节点29
MLIR 算子直方图(前 8)
MLIR top 计算图
在新标签打开 →